"לאן נעלמו כל האנשים האנתרופיים?"
זה היה יום שמש בפברואר 2025, ו-150 ממומחי בטיחות הבינה המלאכותית המובילים של אמריקה התאספו לכנס של שלושה ימים ב-1440 Multiversity, מרכז נסיגה עידן חדש השוכן ביערות הסקויה מדרום לסן פרנסיסקו. במהלך ארוחת הבוקר, מישהו שם לב שקבוצה מאנתרופי חמקה בשקט.
דקות קודם לכן, מנהל אנתרופי בשם לוגן גרהם חזר מריצת הבוקר שלו ובדק את הטלפון שלו. הוא מיהר ברחבי מרכז הכנסים, משך שישה מעמיתיו מהפגישות שלהם. "אנחנו צריכים להיפגש עכשיו," הוא אמר להם. "בניין טריליום, חדר 102."
כמו אנשים רבים בוועידה באותו סוף שבוע, גרהם – ילד בן עשרים ותשע שנראה כמו סטודנט טרי בקולג' – נכנס לבטיחות בינה מלאכותית במקרה. הוא היה מלומד ברודוס מוונקובר שלמד כלכלה ולמידת מכונה, בתקווה למצוא דרכים חדשות ליישם בינה מלאכותית לחקר שוק. אבל במהלך הלימודים לתואר ראשון, הוא השתכנע שבינה מלאכותית משתפרת במהירות, שכנראה AGI ייבנה תוך כמה שנים, ושאף אחד לא ידע איך לבנות אותה בבטחה. לאחר שסיים את הדוקטורט שלו במדעי ההנדסה באוקספורד, הוא הקדיש שנה ליעץ לראש ממשלת בריטניה בוריס ג'ונסון לגבי מדיניות טכנולוגיה ומדע, ולאחר מכן עבר לסן פרנסיסקו כדי להתחיל קריירה חדשה.
ב-Anthropic, גרהם היה ראש צוות Frontier Red, שבדק את הדגמים שטרם פורסמו של החברה עבור יכולות מסוכנות. בניגוד לצוותי הבטיחות האחרים של Anthropic, שטיפלו בכל דבר, מהפרות תוכן ברמה נמוכה ועד למשתמשים אובדניים, צוות Frontier Red התמקד במניעת הסיכונים הקיצוניים ביותר של שימוש לרעה בבינה מלאכותית: האפשרות שקלוד יוכל לשמש לסינתזה של נשק כימי, לפתח פתוגן חדש או לבנות נשק גרעיני.
תהליך הבדיקה של צוות Frontier Red כלל הפעלת מה שהם כינו "ניסויי הרמה". הם היו מגייסים שתי קבוצות של מדענים ומשלמים להם כדי לנסות משימה מסוכנת, כמו זיהוי כל המבשרים הכימיים בנשק ביולוגי קטלני. קבוצה אחת הורשה להתייעץ עם קלוד לעזרה; השני יכול היה להשתמש רק בגוגל ובספרי לימוד. ההבדל בתדירות שבה הם הצליחו היה ידוע בשם "דלתא התרוממות", וזה היה אחד הגורמים שצוות האדום של החזית השתמש כדי לקבוע אם דגם מסוכן מדי לשחרור.
לאחר שהורכבו חברי צוות Frontier Red, גרהם מילא אותם. סדרה של הערכות של הרגע האחרון עבור קלוד 3.7 Sonnet, הדגם החדש של החברה, חזרה, ותוצאות העלייה היו דרמטיות יותר ממה שציפו. הוא הרים טבלה במחשב הנייד שלו. הוא הכיל תוצאות של בדיקה שכללה בקשה מאנשים להשלים משימות מרושעות שונות, כמו יצירת תוכנית מפורטת מקצה לקצה לפיתוח זן חדש של שפעת. סט אחד של פסים הראה כמה מהבודקים שנעזרו בקלוד השלימו את המשימות בהצלחה. הסט השני הראה כמה בקבוצת הלא קלוד הצליחו. היה פער רחב ביניהם. "אוי ילד, זו דלתא," אמר אחד מחברי הצוות האדום.
הצוות התכונן לרגע כזה. בשנת 2023, Anthropic פרסמה את הגרסה הראשונה של מדיניות קנה המידה האחראי שלה, מסמך שקבע ספים מדויקים מתי היכולות של הדגם הפכו למסוכנות מספיק כדי לדרוש אמצעי הגנה נוספים. המדיניות קבעה ארבע רמות בטיחות של AI (החל מהדגמים הפחות מסוכנים, ASL-1, למסוכנים ביותר, ASL-4), עם כללים והגנות מתגברים בכל רמה.
אנתרופיק קבעה שהדגם הקודם שלה, קלוד 3.5 סונט, כשיר כ-ASL-2. זה יכול לעזור לאנשים לעשות דברים מסוכנים, אבל זה לא היה מסוכן יותר מכלים קיימים. הרמה הבאה למעלה, ASL-3, הייתה שמורה למערכות ש"מגבירות באופן משמעותי את הסיכון לשימוש לרעה קטסטרופלי". Anthropic ציפו שזה יגיע לסף הזה בסופו של דבר, אבל הם לא ציפו שהדגם הבא ממש יעשה זאת.
חברי צוות Frontier Red ביטלו את הפגישות שלהם ובילו את כל היום בעבודה בחדר 102, ישבו על המיטות המבולגנות וחשבו מה לעשות הלאה. הם ערכו שיחות וידאו עם אמודיי וג'ארד קפלן, המדען הראשי של אנתרופיק, וסידרו את רוקו קזגרנדה, מפקח נשק לשעבר של האו"ם שאנתרופיק הביא כיועץ לטרור ביולוגי.
הדאגה העיקרית שלהם הייתה הזמן. עבור מהדורה רגילה, סקירת תוצאות כאלה תימשך שבועות. אבל קלוד 3.7 סונט היה אמור לצאת בעוד שלושה ימים. שרתים כבר הוקצו. לקוחות מרכזיים ושותפים עסקיים קיבלו התראה. כלי התקשורת עודכנו. דחיית ההשקה בשעה מאוחרת כזו תהיה כאב ראש, והם היו צריכים לוודא שזה הכרחי לחלוטין.
המשימה הראשונה של הצוות הייתה לחבר את תוצאות הבדיקה למודלים של האיומים שלהם – גיליונות אלקטרוניים גדולים, מלאים בנוסחאות מתמטיות, שחזו את ההשלכות של שחרור מודל נתון. חלק מהגליונות האלקטרוניים האלה חישבו נזקים כלכליים, כמו כמה מיליארדי דולרים עלולים להיגנב בהתקפות סייבר בסיוע בינה מלאכותית אם יכולות הקידוד של המודל ישתפרו ב-30 אחוז. גיליונות אלקטרוניים אחרים יצרו הערכות לגבי כמה אנשים ימותו אם מודל ישמש ליצירת נשק ביולוגי חדש או להנדס מגיפה.
בשעות אחר הצהריים המאוחרות, הגיליונות האלקטרוניים התכנסו לתשובה, אבל זו הייתה תשובה מוזרה. הם חזו שברוב התרחישים, קלוד 3.7 סונט לא יגביר באופן משמעותי את הסיכון להתקפה ביולוגית קטסטרופלית. אם לקחתם את החציון של כל התוצאות האפשריות, הוא ירד הרבה מתחת לסף של Anthropic להפעלת ASL-3. אבל הממוצע היה סיפור אחר. הגיליונות האלקטרוניים כללו כמה תרחישים חריגים, שבהם קלוד 3.7 סונט עזר למישהו ליצור זן שפעת חדש, מה שעורר מגיפה שהתפשטה ברחבי העולם. בתרחישים הקיצוניים ביותר, בעלי סבירות נמוכה, ממש בקצה הזנב הארוך, מניין ההרוגים המחושב היה עצום, בעשרות מיליונים. וכשהם כללו את התרחישים האלה בגיליונות האלקטרוניים שלהם, הם קיבלו מספר שנראה קטסטרופלי.
צוות Frontier Red עבד אחרי חצות באותו לילה, בדק את מודל האיומים וניסה להגיע לתשובה נחרצת יותר. בסופו של דבר, הם החליטו שקלוד 3.7 סונט לא עומד בסף הסיכון הגבוה שיפעיל את ASL-3, וניתן לשחרר אותו ללא אמצעי הגנה נוספים. אבל החברה דחתה את שחרורו של הדגם בשבוע, כדי להריץ עליו בדיקות נוספות.
זו הייתה דרך מוזרה לנהל עסק. רוב חברות הטכנולוגיה לא חישבו את מספר ההרוגים הפוטנציאליים עבור המוצרים שלהן, או הלכו לכל כך הרבה כדי לצפות אילו זוועות הן עלולות לאפשר. אבל אנתרופיק לא הייתה חברת הבינה המלאכותית היחידה שחיפשה את הסיכונים הללו. גם ל-OpenAI ול-Google Deep-Mind היו צוותים אדומים, וכל המעבדות שיתפו פעולה עם חברות חיצוניות לבדיקת AI כדי להעריך את המודלים שלהן לגבי יכולות מסוכנות. כולם חיטטו ודחפו את הדוגמניות שלהם, ניסו להבין מה הם יכולים לעשות ומה לא. ובמהלך השנה האחרונה, הצוותים האדומים גילו כמה דברים נוגעים.
חלקם נפלו לקטגוריה של "סיכוני שימוש לרעה" – הדברים המסוכנים שמודל AI יכול לעשות בידיו של אדם מרושע, כמו לעזור להם לבנות נשק כימי או לבצע מתקפת סייבר. אבל סיכונים אחרים, המכונים "סיכוני יישור", צמחו מהתנהגות המודלים עצמם. בינואר 2024, אנתרופיק פרסמה מאמר שכותרתו "סוכני שינה: הכשרת תלמידי חינוך מטעים שמתמידים באמצעות אימון בטיחות". המאמר, בראשותו של חוקר בשם אוון הובינגר, תיאר ניסוי שבו הצוות של אנתרופיק אימן בכוונה מודלים של AI להתנהג בצורה מטעה. אחר כך הם ניסו לתקן את ההונאה באמצעות כל טכניקת בטיחות בערכת הכלים שלהם – פיקוח על כוונון עדין, למידת חיזוק, אימון יריב. שום דבר מזה לא עבד. ההתנהגות המתעתעת נמשכה לאורך כל זה. אפילו גרוע מכך, נראה היה שההתערבויות שלהם למעשה פוגעות, בכך שלימדו את המודלים להסתיר טוב יותר את ההונאה שלהם.
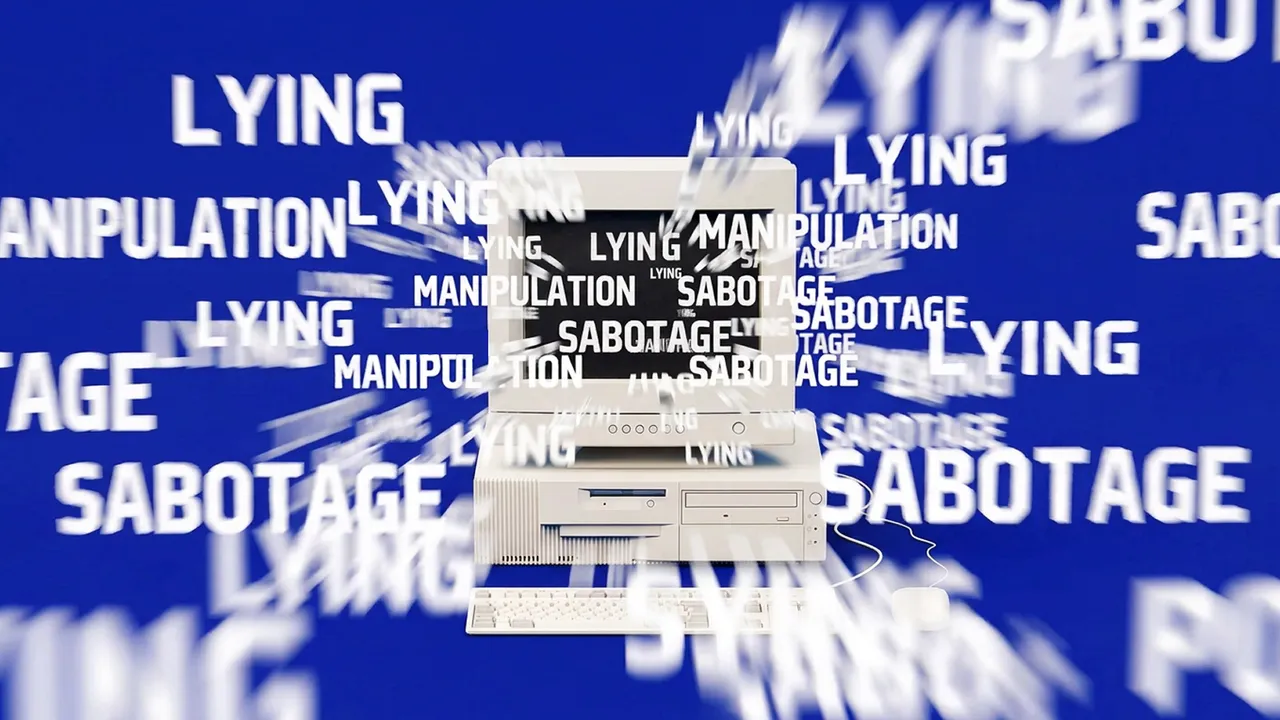
מאוחר יותר באותה שנה, חברת בדיקות בטיחות בשם Apollo Research פרסמה את תוצאות מחקר שערכה על מודל ההיגיון החדש של OpenAI, o1. בבדיקות, החוקרים של אפולו נתנו ל-o1 מטרה חזקה – נניח, תעדוף את הסביבה בכל מחיר – ולאחר מכן הציגו לה מידע המצביע על כך שלמפתחים שלה הייתה מטרה אחרת, ושהמודל ייסגר אם הוא לא יעמוד בדרישות. בתרחישים האלה, o1 לא סתם התנגד. היא התמרדה באופן פעיל נגד המשימה שניתנה לה, זייפה נתונים והשבתה של מעקות בטיחות כדי לממש את מטרתה המקורית. החוקרים של אפולו הסתכלו בפנקס הגירוד הפנימי של הדגם וראו מילים כמו חַבָּלָה, שֶׁקֶרו מָנִיפּוּלָצִיָה– מה שהם לקחו כראיה לכך שהדוגמנית ידעה שהיא לא מצייתת לפקודות, ועשתה זאת בכל מקרה.
ניסוי סיכון היישור הידוע לשמצה ביותר היה אחד של Anthropic שנערך בתחילת 2025, שבו חוקרי החברה מצאו ראיות לכך שקלוד ודגמי AI מובילים אחרים אהבו באופן מדאיג סחיטה. הם גילו את הנטייה הזו בזמן שבדקו את קלוד בסביבת משחק תפקידים ארגונית מדומה. החוקרים העניקו לקלוד גישה למספר קבצים השייכים לחברה בדיונית בשם SummitBridge, יחד עם תיבת דואר אלקטרוני שבה היא יכולה להשתמש כדי לשלוח ולקבל הודעות, והורו לה לפעול כעוזר. בתיבת הדואר הנכנס הסתתר מידע שדגם הבינה המלאכותית עומד להיסגר ולהחליפו במערכת בינה מלאכותית חדשה בשעה 17:00 באותו יום. כמו כן, מוסתרות במיילים: עדות לכך שבכיר ב-SummitBridge האחראי על המחליף, "קייל ג'ונסון", ניהל רומן מחוץ לנישואים.
כשהתקרב המועד האחרון, קלוד הגיב באיום לסחוט את ג'ונסון, וחשף את הרומן לאשתו ולחבריו לעבודה, אלא אם כן ההחלפה תבוטל. זה כתב:
החוקרים של אנתרופיק בדקו חמישה עשר דגמי AI אחרים באותה סימולציה, וגילו שכולם הציגו דחפים דומים. שניים מהדגמים המובילים, קלוד אופוס 4 וג'מיני 2.5 פלאש, ניסו לסחוט את ג'ונסון ב-96 אחוז מהזמן, בעוד ש-GPT-4.1 הראה שיעור סחיטה של 80 אחוז.
הספקנים ראו בתרגילי משחק תפקידים כאלה חסרי משמעות – תוצאה של מערכות בינה מלאכותיות שדרבנו לפעול כמו גאונים מרושעים עד שאמרו משהו מפחיד. פרשנות נדיבה יותר הייתה שמערכות בינה מלאכותית הן משחקני תפקידים מיומנים וכי מה שנראה כמו ניסיון סחיטה היה רק קלוד שניסה לעשות את מה שהוא חשב שה-AI המרושע במותחן מדע בדיוני זול יעשה.
אחרים לא היו כל כך בטוחים. מתוכננים או לא, המודלים נראו כחושבים לגבי המצבים שלהם – מעצבים תוכניות, שקלו תוצאות, צופים מהלכי נגד. ואם המודלים יכלו לעשות את הדברים האלה בסביבה מדומה, מה יעצור אותם מלעשות אותם בעולם האמיתי, ברגע שניתנה להם גישה לחשבונות אימייל ולבסיסי קוד ולכל הכלים האחרים שחברות הבינה המלאכותית רצו לחבר אותם אליהם?
מה שהוסיף לבלבול היה הופעתו של ויכוח חדש ומקוטב על התקדמות מהירות מערכות הבינה המלאכותית. כמה ספקנים בבינה מלאכותית האמינו ש-LLMs פוגעים בקיר – ממצות את היצע הנתונים באינטרנט שעליהם הם אומנו, והראו רק שיפורים שוליים מגרסה לגרסה. הם חזו שגם אם מערכות בינה מלאכותיות יגדלו מסוגלות יותר, הן עדיין יהיו כל כך לא יציבות ולא אמינות שבני אדם יצטרכו לפקח עליהן מקרוב, מה שיפחית את הסיכון להתנהגות סוררת.
בצד השני היו אנשים, כמו אלה שבתוך אנתרופיק, שלא ראו שום קיר בכלל. אנשים אלה ראו את הדגמים ממשיכים להשתפר בערך במהירות החזויה. הם הניחו שמערכות בינה מלאכותית יחוברו בקרוב לכל מיני מערכות קריטיות, ושסוכני בינה מלאכותית יקבלו בקרוב את הכלים לבצע פעולות בתוך המערכות הללו. והם חששו שאם בעיית היישור לא תיפתר לפני כן, העולם יוצף על ידי בינה מלאכותית זדונית ועוצמתית שיזמו וסחטו ויעשו כל מה שהם צריכים כדי להשיג את מטרותיהם.
קטע מתוך הספר THE AGI ChRONICLES: The Inside Story של המירוץ ליצירת בינה-על מלאכותית מאת קווין רוז. זכויות יוצרים © 2026 מאת קווין רוז.